Khung 5C giao tiếp với AI gồm Clarify, Context, Command, Challenge và Check. Đây là một framework thực hành giúp người dùng giữ quyền chủ động: xác định mục tiêu trước khi hỏi, cung cấp bối cảnh cần thiết, ra yêu cầu có cấu trúc, chủ động chất vấn câu trả lời và kiểm chứng bằng nguồn độc lập. 5C không phải mô hình đã được kiểm định đúng nguyên dạng, nhưng từng thành phần có nền tảng từ nghiên cứu về AI literacy, prompt engineering, human–AI interaction, metacognition, automation bias và hallucination.
TL;DR
💡TL;DR / KEY TAKEAWAYS
5C không nhằm tạo “prompt hoàn hảo”; nó biến việc dùng AI thành một vòng lặp có mục tiêu, bối cảnh, yêu cầu, phản biện và kiểm chứng để con người vẫn là người chịu trách nhiệm cuối cùng.
5C là framework tổng hợp dựa trên bằng chứng, chưa phải mô hình đã được peer-review đúng nguyên dạng.
Clarify–Context–Command giúp đặc tả nhiệm vụ; Challenge–Check giúp chống chấp nhận thụ động và overreliance.
Prompt tốt không loại bỏ hallucination; claim quan trọng vẫn cần nguồn độc lập.
Cognitive forcing có thể giảm overreliance nhưng làm tăng nỗ lực nhận thức, vì vậy mức kiểm chứng nên theo rủi ro.
Trong giáo dục, nên đánh giá cả quy trình dùng AI: mục tiêu, nguồn, phản biện và kiểm chứng.
Khung 5C giao tiếp với AI gồm Clarify – Context – Command – Challenge – Check. Đây không nên được hiểu như một “công thức prompt thần kỳ”, mà như một vòng lặp kiểm soát nhận thức: con người xác định mục tiêu, cung cấp thông tin cần thiết, ra yêu cầu có cấu trúc, chủ động chất vấn kết quả và kiểm chứng trước khi sử dụng. Nền tảng của cách tiếp cận này hội tụ từ nhiều nhánh nghiên cứu: AI literacy, prompt engineering, human–AI interaction, metacognition, automation bias, critical thinking và nghiên cứu về hallucination của mô hình ngôn ngữ lớn [1–10].
Điểm quan trọng nhất: AI có thể hỗ trợ suy nghĩ, nhưng không nên thay con người xác định mục tiêu, đánh giá bằng chứng và chịu trách nhiệm cho quyết định cuối cùng. Nghiên cứu về human–AI interaction và overreliance cho thấy vấn đề không chỉ nằm ở độ chính xác của AI mà còn ở cách con người phân bổ sự chú ý, niềm tin và quyền quyết định cho hệ thống [3,7–9].
1. Vì sao cần một khung giao tiếp với AI thay vì chỉ học “viết prompt hay”?
Khi generative AI trở thành công cụ phổ biến trong học tập, nghiên cứu và công việc tri thức, chất lượng tương tác không còn phụ thuộc đơn thuần vào việc người dùng có biết một vài “mẹo prompt” hay không. Các tổng quan về prompt engineering cho thấy hiệu quả của prompt chịu ảnh hưởng bởi nhiều thành phần: cách mô tả nhiệm vụ, thông tin bối cảnh, ví dụ, ràng buộc đầu ra, chiến lược suy luận, cơ chế phản hồi và kiểm chứng [4–6]. Đồng thời, literature về AI literacy nhấn mạnh rằng năng lực sử dụng AI phải bao gồm hiểu giới hạn hệ thống, đánh giá đầu ra, cân nhắc đạo đức và duy trì quyền chủ động của con người [1,2].
Điều này dẫn đến một chuyển dịch quan trọng:
Giao tiếp tốt với AI không chỉ là “nói sao để AI làm đúng”, mà là tổ chức một quy trình để con người vẫn là chủ thể của mục tiêu, tiêu chuẩn, bằng chứng và quyết định.
Các hướng dẫn kinh điển về human–AI interaction của Amershi và cộng sự cũng nhấn mạnh việc hệ thống AI cần hỗ trợ người dùng hiểu khả năng, sửa lỗi, điều chỉnh hành vi và duy trì khả năng kiểm soát [3]. Trong bối cảnh GenAI, nghiên cứu CHI 2025 trên 319 knowledge workers cho thấy mức tin tưởng cao vào GenAI có liên hệ với việc báo cáo ít thực hành tư duy phản biện hơn; ngược lại, sự tự tin vào năng lực bản thân có liên hệ với mức độ tư duy phản biện cao hơn. Nghiên cứu cũng cho thấy bản chất của critical thinking chuyển mạnh sang kiểm chứng thông tin, tích hợp câu trả lời và giám sát nhiệm vụ [7].
Vì vậy, một framework hữu ích phải bao phủ cả hai lớp:
Lớp giao tiếp với mô hình — để AI hiểu đúng nhiệm vụ và tạo đầu ra phù hợp.
Lớp kiểm soát nhận thức của người dùng — để tránh giao luôn việc suy nghĩ, đánh giá và quyết định cho AI.
2. Vị thế khoa học của “Khung 5C”
Trong phạm vi tìm kiếm tài liệu được thực hiện cho bài viết này, chưa tìm thấy một công trình peer-reviewed xác lập và kiểm định thực nghiệm đúng chuỗi năm thành phần Clarify – Context – Command – Challenge – Check như một thang đo hay mô hình chuẩn hóa. Ngoài học thuật cũng tồn tại các framework mang tên “5C” nhưng dùng các chữ C khác nhau; thậm chí có preprint đề xuất 5C Prompt Contract với Character, Cause, Constraint, Contingency và Calibration. Vì vậy, tên “5C” không phải một thuật ngữ học thuật duy nhất có định nghĩa thống nhất.
Trong bài viết này, 5C được trình bày như một framework tổng hợp thực hành (evidence-informed synthesis). Mỗi thành phần được ánh xạ tới những cơ chế đã có cơ sở nghiên cứu:
Clarify → goal setting, problem scoping, metacognition, task stewardship [7,14,16].
Context → in-context learning, contextual information, examples, grounding [4–6].
Command → explicit instruction, constraints, output specification, prompt patterns [4–6].
Challenge → cognitive forcing, alternative generation, critique, iterative refinement [8,12,13].
Check → verification, factuality checking, hallucination mitigation, human oversight [9–11,15–17].
Cách định vị này quan trọng: 5C không tuyên bố thay thế các mô hình đã được kiểm định; nó là một “giao diện nhận thức” ngắn gọn giúp người dùng vận dụng các nguyên tắc đã được nghiên cứu.
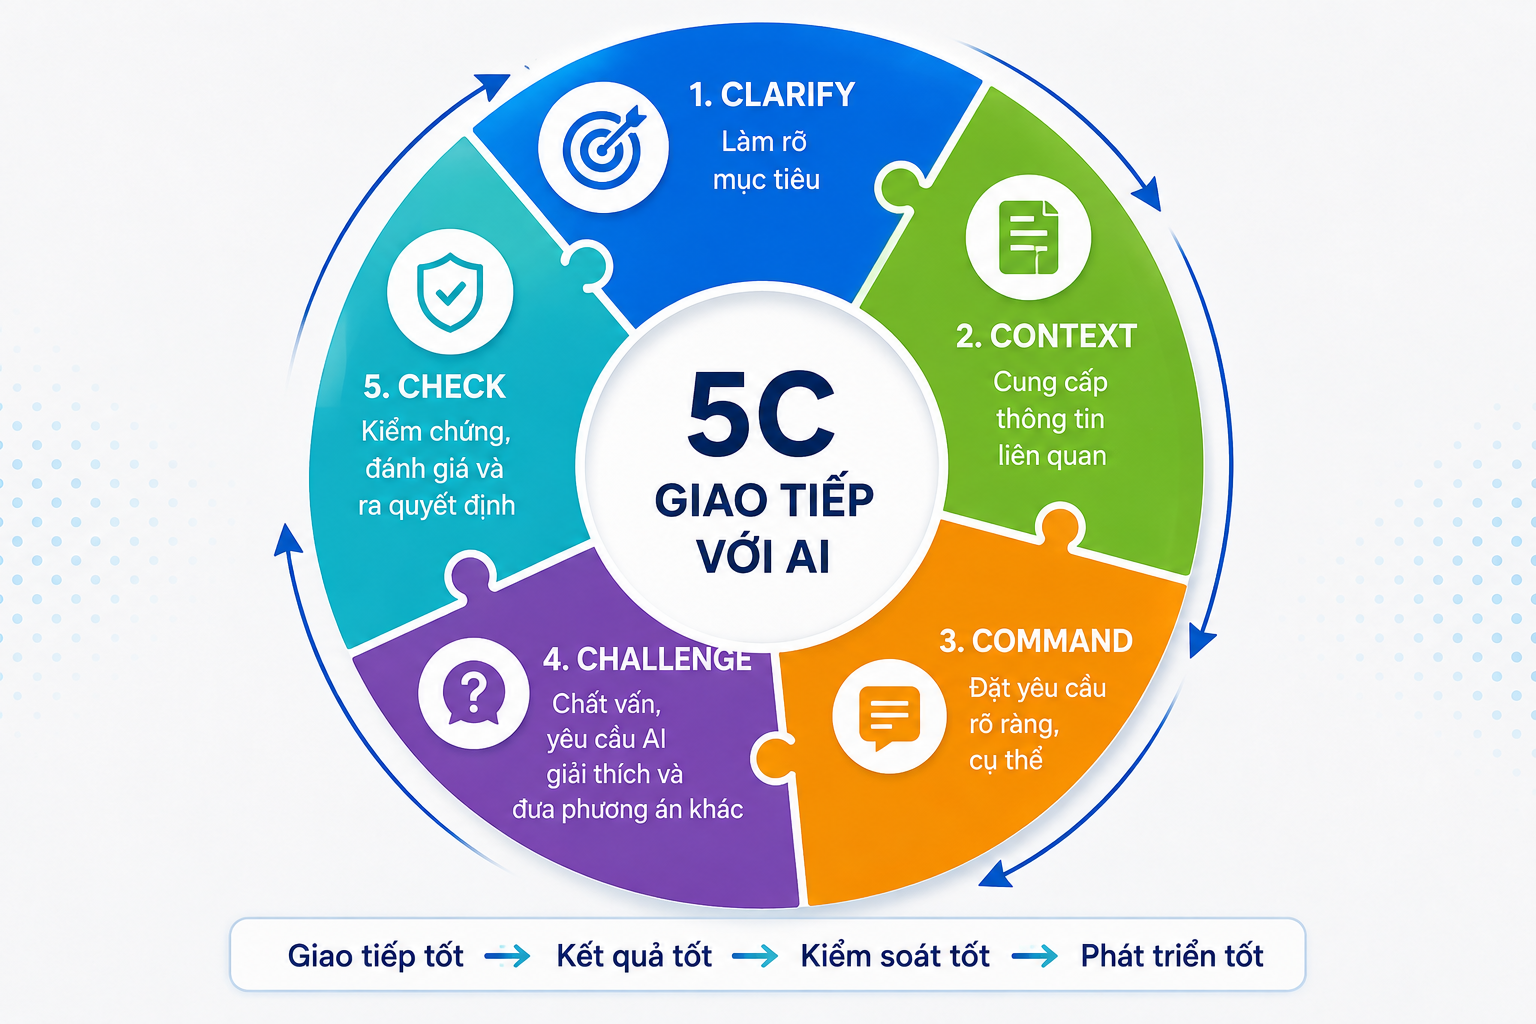
Sơ đồ Khung 5C giao tiếp với AI gồm Clarify, Context, Command, Challenge và Check như một vòng lặp kiểm soát nhận thức
3. C1 — Clarify: Làm rõ mục tiêu trước khi hỏi AI
3.1. Clarify thực sự giải quyết vấn đề gì?
Một trong những lỗi phổ biến nhất khi dùng AI là bắt đầu bằng câu hỏi trước khi người dùng xác định rõ mình đang muốn đạt điều gì. Khi mục tiêu mơ hồ, người dùng dễ đánh giá câu trả lời dựa trên cảm giác “nghe có vẻ hay” thay vì dựa trên tiêu chí thành công.
Clarify yêu cầu người dùng xác định tối thiểu bốn yếu tố:
Mục tiêu cuối cùng là gì?
Đối tượng sử dụng kết quả là ai?
Quyết định hoặc sản phẩm nào sẽ được tạo ra từ kết quả của AI?
Tiêu chí thành công là gì?
Ví dụ, thay vì hỏi:
“Hãy viết cho tôi bài về AI trong giáo dục.”
Clarify tốt hơn là:
“Tôi cần một bài phân tích 2.500–3.000 từ dành cho giáo viên phổ thông Việt Nam, mục tiêu giúp họ hiểu cách dùng GenAI mà không làm suy giảm tư duy phản biện của học sinh. Bài phải có bằng chứng nghiên cứu, ví dụ lớp học và checklist triển khai.”
3.2. Nền tảng nghiên cứu
Long và Magerko định nghĩa AI literacy không chỉ là sử dụng công cụ, mà còn bao gồm các năng lực giúp con người đánh giá, giao tiếp và cộng tác hiệu quả với AI [1]. UNESCO cũng đặt human agency và problem scoping vào lõi năng lực AI của người học và giáo viên [15–17].
Ở góc độ cognition, Clarify tương ứng với một phần của metacognition: người dùng phải biết mình đang giải quyết vấn đề gì, cần loại bằng chứng nào và khi nào câu trả lời là “đủ tốt”. Nghiên cứu về hỗ trợ metacognitive trong môi trường GenAI cho thấy việc đưa các prompt hỗ trợ siêu nhận thức có thể cải thiện self-regulated learning và trải nghiệm học tập, dù bằng chứng hiện tại vẫn còn cần mở rộng về quy mô và bối cảnh [14].
Nghiên cứu CHI 2025 cũng ghi nhận rằng knowledge workers mô tả critical thinking khi dùng GenAI bằng những hành vi như đặt mục tiêu, tinh chỉnh prompt và đánh giá kết quả [7]. Điều này cho thấy “làm rõ nhiệm vụ” không chỉ là bước viết prompt; nó là một thao tác tư duy giúp duy trì ownership của người dùng.
3.3. Câu hỏi Clarify gợi ý
Trước khi mở chatbot, hãy tự trả lời:
Tôi đang cố tạo câu trả lời, quyết định, hay sản phẩm?
Tôi đã biết điều gì? Điều gì còn chưa chắc?
Nếu AI đưa ra ba phương án khác nhau, tôi dùng tiêu chí nào để chọn?
Rủi ro nếu câu trả lời sai là thấp, trung bình hay cao?
Nguyên tắc: nếu bạn chưa thể mô tả “điểm đến”, đừng giao cho AI chọn “lộ trình”.
4. C2 — Context: Cung cấp bối cảnh cần thiết, không ném dữ liệu vô tội vạ
4.1. Vì sao context quan trọng?
LLM tạo phản hồi dựa trên chuỗi đầu vào và các mẫu đã học. Khi người dùng cung cấp thông tin bối cảnh, ví dụ, định nghĩa, dữ liệu nguồn hoặc tiêu chuẩn, mô hình có thêm tín hiệu để ràng buộc không gian câu trả lời. Các tổng quan prompt engineering đều xem context, examples, instruction và knowledge grounding là thành phần trung tâm của thiết kế prompt [4–6].
Tuy nhiên, “càng nhiều context càng tốt” là một hiểu lầm. Context tốt phải liên quan và có mục đích. Thông tin thừa, mâu thuẫn hoặc không rõ nguồn có thể làm tăng nhiễu, khiến mô hình ưu tiên sai tín hiệu hoặc làm người dùng khó kiểm soát những gì đã được đưa vào nhiệm vụ.
4.2. Bốn loại context hữu ích
Context nhiệm vụ: tại sao nhiệm vụ này cần làm, đầu ra được dùng ở đâu.
Context người dùng/đối tượng: trình độ, độ tuổi, vai trò, nhu cầu, ngôn ngữ.
Context chuyên môn: thuật ngữ, tiêu chuẩn, dữ liệu, tài liệu tham chiếu, quy định.
Context ràng buộc: thời gian, độ dài, công cụ, nguồn được phép dùng, điều không được làm.
Ví dụ:
“Đối tượng là học sinh lớp 4, thời lượng 100 phút, dùng PictoBlox word block. Hoạt động trước phần coding phải là hoạt động không dùng máy tính. Chuẩn tham chiếu CSTA 1B.”
Một prompt như vậy không chỉ cung cấp nội dung; nó xác lập không gian thiết kế để AI ít có xu hướng đưa ra gợi ý không phù hợp.
4.3. Context không phải là bằng chứng xác thực
Ngay cả khi được cung cấp tài liệu, LLM vẫn có thể diễn giải sai, bỏ sót, hoặc tạo nội dung không trung thành với nguồn. Survey về hallucination phân biệt cả factuality hallucination và faithfulness hallucination — tức đầu ra có thể sai với thế giới thực hoặc không nhất quán với context đã cung cấp [10]. Vì vậy, Context giúp tăng grounding nhưng không loại bỏ bước Check.
5. C3 — Command: Chuyển mục tiêu thành chỉ dẫn có cấu trúc
5.1. “Command” không có nghĩa là ra lệnh cứng nhắc
Trong 5C, Command là bước chuyển mục tiêu và bối cảnh thành một đặc tả nhiệm vụ có thể kiểm tra. Prompt engineering research cho thấy nhiều kỹ thuật hiệu quả dựa trên việc mô tả rõ vai trò, nhiệm vụ, các bước, format đầu ra, ví dụ và ràng buộc [4–6].
Một Command tốt thường trả lời sáu câu hỏi:
Làm gì?
Cho ai?
Dựa trên nguồn/tiêu chuẩn nào?
Theo cấu trúc nào?
Điều gì bắt buộc / bị cấm?
Đầu ra phải có dạng gì để tôi kiểm tra được?
5.2. Từ “prompt hay” sang “specification”
Ví dụ yếu:
“Cho tôi kế hoạch bài học STEM thật hay.”
Ví dụ mạnh hơn:
“Thiết kế lesson plan 100 phút cho học sinh 9–11 tuổi theo 5E. Mỗi learning objective gồm ba bước: hướng dẫn kiến thức mới, hoạt động unplugged, thử thách lập trình PictoBlox. Với mỗi thuật ngữ mới, định nghĩa, ví dụ, bối cảnh sử dụng và mapping CSTA. Cuối bài có nâng cấp dự án, chia sẻ, game hóa ôn tập và exit ticket. Trình bày bằng tiếng Việt.”
Điểm khác biệt không nằm ở độ dài, mà ở khả năng kiểm định. Người dùng có thể nhìn vào đầu ra và đánh dấu phần nào đạt, phần nào thiếu.
5.3. Cẩn trọng với “role prompting” và ngôn ngữ tạo cảm giác chắc chắn
Việc nói “hãy là chuyên gia hàng đầu thế giới” không biến mô hình thành chuyên gia đã được cấp phép, cũng không bảo đảm tính đúng đắn. Role prompt có thể giúp định hình phong cách hoặc góc nhìn, nhưng không thay thế nguồn bằng chứng, kiểm chứng và trách nhiệm chuyên môn. Đây là lý do Command cần đi cùng Challenge và Check.
6. C4 — Challenge: Chủ động chất vấn AI thay vì chỉ yêu cầu “viết lại cho hay hơn”
6.1. Challenge là “cognitive forcing” ở cấp độ hội thoại
Khi AI tạo câu trả lời lưu loát, người dùng rất dễ dừng suy nghĩ sớm. Đây là một biểu hiện liên quan tới automation bias/overreliance: con người chấp nhận khuyến nghị tự động ngay cả khi khuyến nghị đó sai [8,9].
Buçinca và cộng sự thử nghiệm các cognitive forcing functions với 199 người tham gia và cho thấy các cơ chế buộc người dùng suy nghĩ về khuyến nghị AI có thể giảm overreliance so với cách chỉ hiển thị giải thích đơn giản, dù chúng có thể làm giảm mức “thích” chủ quan vì đòi hỏi nhiều nỗ lực nhận thức hơn [8]. Đây là bằng chứng rất quan trọng cho thiết kế 5C: ma sát nhận thức không phải lúc nào cũng xấu; đôi khi chính nó bảo vệ chất lượng quyết định.
6.2. Những câu Challenge mạnh
Thay vì hỏi “Bạn chắc không?”, hãy yêu cầu AI thực hiện các thao tác có cấu trúc:
“Nêu 3 giả định quan trọng mà câu trả lời này đang dựa vào.”
“Điểm yếu lớn nhất của phương án này là gì?”
“Đưa ra một phương án cạnh tranh có logic khác hẳn.”
“Trong trường hợp nào kết luận này sẽ sai?”
“Hãy đóng vai reviewer phản biện và chỉ ra phần thiếu bằng chứng.”
“Tách các phát biểu thành: fact / inference / recommendation.”
“Nêu điều gì bạn không biết hoặc không đủ dữ liệu để kết luận.”
Các kỹ thuật kỹ thuật như Self-Refine cho thấy việc tạo feedback rồi lặp lại refinement có thể cải thiện kết quả trên nhiều nhiệm vụ so với generation một bước [12]. Tree of Thoughts cho thấy việc khám phá và đánh giá nhiều đường suy luận có thể cải thiện hiệu suất trong các bài toán cần planning/search [13]. Tuy nhiên, đây là kỹ thuật làm mô hình suy luận tốt hơn, không phải bằng chứng rằng mô hình tự phê bình sẽ luôn phát hiện được lỗi của chính nó.
6.3. Tại sao “AI tự kiểm tra AI” vẫn chưa đủ?
Một mô hình có thể lặp lại cùng một sai lầm ở nhiều lần sinh, hoặc tạo giải thích nghe hợp lý cho kết luận sai. Vì thế Challenge nên có hai lớp:
Internal challenge: yêu cầu chính AI đưa phản biện, giả định, phương án khác.
External challenge: đối chiếu với nguồn độc lập, dữ liệu thật hoặc chuyên gia con người.
Challenge tốt tạo ra đa dạng giả thuyết; Check mới quyết định giả thuyết nào đứng vững trước bằng chứng.
7. C5 — Check: Kiểm chứng, đánh giá và chịu trách nhiệm trước khi sử dụng
7.1. Tại sao Check là bước bắt buộc?
LLM có thể tạo nội dung trôi chảy nhưng sai thực tế. Tổng quan trên ACM Transactions on Information Systems về hallucination mô tả hiện tượng này như một vấn đề nền tảng của LLM và phân tích nhiều nguyên nhân từ dữ liệu, huấn luyện tới suy luận [10]. Do đó, độ tự tin trong giọng văn của AI không phải thước đo độ đúng.
Check yêu cầu ít nhất bốn lớp:
Factual check — dữ kiện, số liệu, tên người, ngày tháng, trích dẫn có đúng không?
Source check — nguồn có tồn tại, có phải nguồn gốc, có thực sự hỗ trợ claim không?
Logic check — kết luận có theo từ tiền đề không? Có đánh tráo tương quan thành nhân quả không?
Fit-for-purpose check — dù đúng, câu trả lời có phù hợp mục tiêu, đối tượng, đạo đức, quy định và rủi ro không?
7.2. Chain-of-Verification và ý nghĩa thực hành
Nghiên cứu Chain-of-Verification đề xuất quy trình: tạo bản nháp, sinh câu hỏi kiểm chứng, trả lời các câu kiểm chứng độc lập rồi tạo đáp án cuối; các thử nghiệm ban đầu cho thấy phương pháp này có thể giảm hallucination ở nhiều loại tác vụ [11]. Các biến thể sau đó tích hợp verification vào RAG cũng cho thấy hướng tiếp cận “retrieve–verify–revise” có tiềm năng cải thiện tính nhất quán với nguồn.
Tuy vậy, từ góc nhìn người dùng, bài học quan trọng hơn là:
Kiểm chứng phải được thiết kế thành một bước riêng, thay vì hy vọng rằng một prompt tốt sẽ khiến hallucination biến mất.
7.3. Quy tắc mức độ kiểm chứng theo rủi ro
Rủi ro thấp: ý tưởng brainstorming, cách diễn đạt → kiểm tra logic và phù hợp.
Rủi ro trung bình: nội dung học tập, báo cáo nội bộ → kiểm nguồn chính, số liệu, thuật ngữ.
Rủi ro cao: y tế, pháp lý, tài chính, an toàn, quyết định nhân sự → AI chỉ là nguồn hỗ trợ; cần nguồn sơ cấp và chuyên gia có trách nhiệm.
UNESCO nhấn mạnh cách tiếp cận human-centred, human agency và trách nhiệm con người trong sử dụng GenAI cho giáo dục [15–17]. Đây là lý do Check không thể được “ủy quyền hoàn toàn” cho chatbot.
8. 5C như một vòng điều khiển: bạn là người lái, AI là hệ thống hỗ trợ
Một cách hiểu sai phổ biến là xem AI như “chế độ lái tự động”: người dùng đưa một điểm đến rồi chấp nhận kết quả. Cách hiểu phù hợp hơn với nghiên cứu human–AI collaboration là AI như một hệ thống hỗ trợ quyết định trong vòng lặp có con người giám sát [3,8,9].
Người dùng giữ vai trò | Nếu biến AI thành “autopilot” |
|---|
Xác định mục tiêu và tiêu chí | AI vô tình xác định vấn đề thay bạn |
Chọn context và nguồn | AI tự lấp chỗ trống bằng giả định |
Đặt ràng buộc và yêu cầu | Đầu ra nghe hợp lý nhưng không đúng nhu cầu |
Chất vấn và yêu cầu phương án khác | Câu trả lời đầu tiên trở thành điểm neo nhận thức |
Kiểm chứng và ra quyết định | Người dùng chuyển trách nhiệm sang hệ thống |
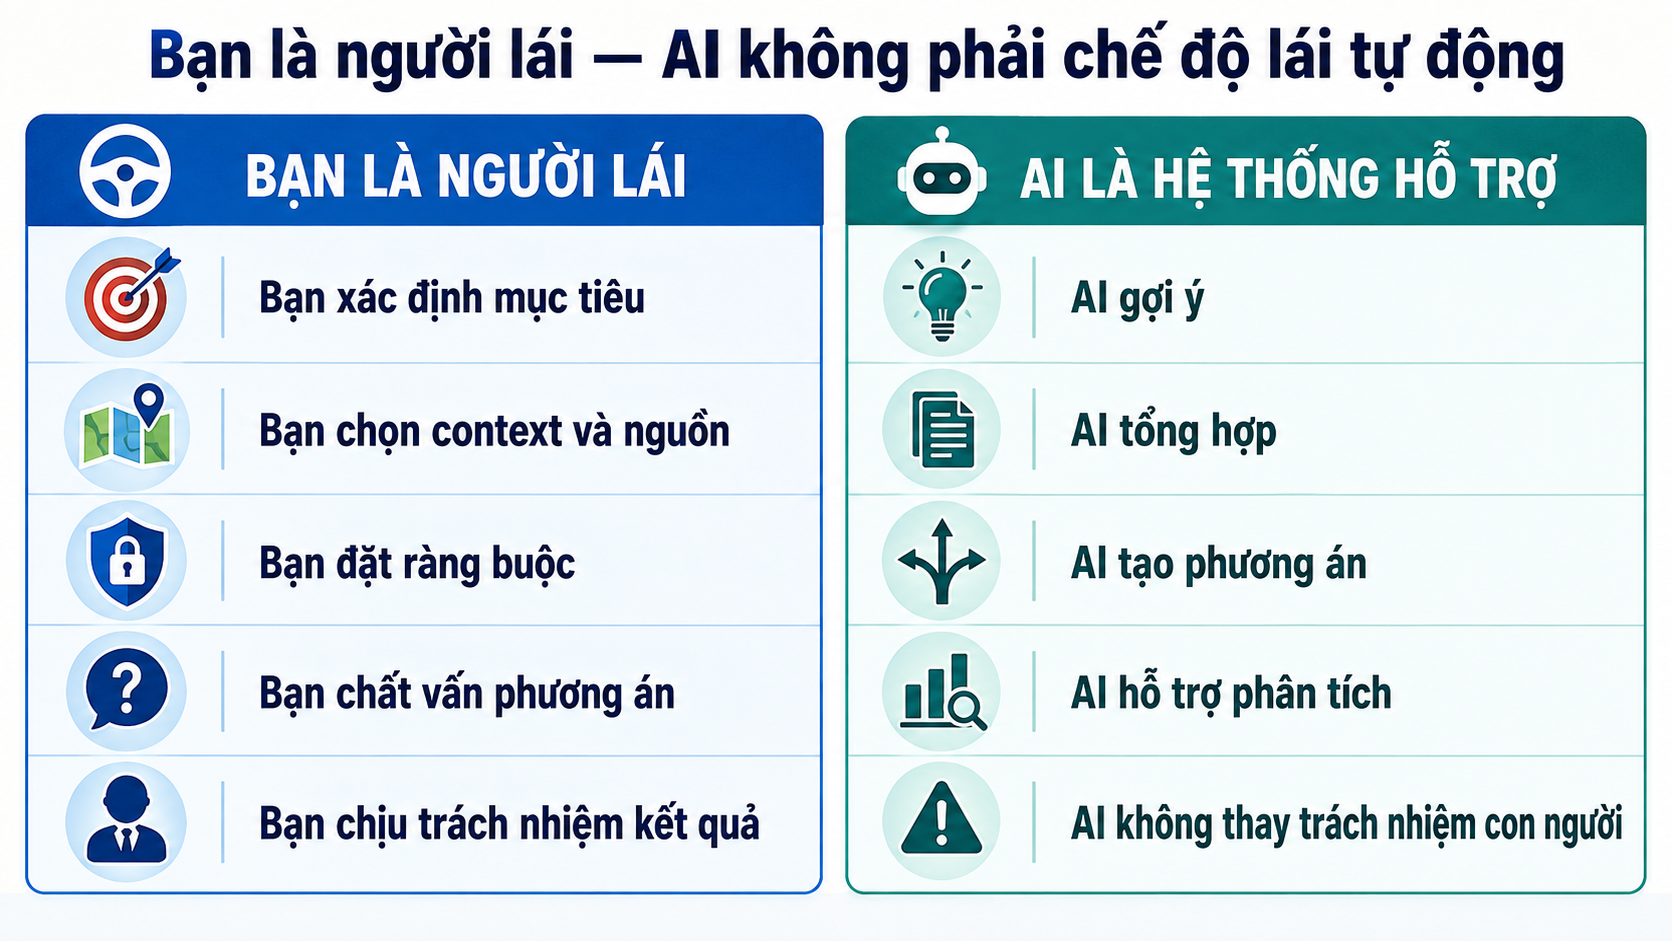
Bảng so sánh vai trò của con người và AI, nhấn mạnh người dùng giữ mục tiêu, kiểm soát và trách nhiệm cuối cùng
Điểm mấu chốt ở đây là calibrated reliance — dựa vào AI ở mức phù hợp với độ tin cậy của hệ thống, năng lực bản thân và rủi ro nhiệm vụ. Literature về automation bias cho thấy cả thiết kế hệ thống, AI literacy, chuyên môn người dùng, áp lực nhiệm vụ và mức độ giải thích đều có thể ảnh hưởng cách con người dựa vào AI [9].
9. Checklist 60 giây: AI đang giúp bạn hay đang thay bạn suy nghĩ?
Trước khi dùng đầu ra của AI, có thể thực hiện một “cognitive pause” 60 giây với năm câu hỏi:
Mục tiêu của tôi là gì? Tôi đã xác định rõ kết quả cần đạt chưa?
AI có đủ context không? Dữ liệu, nguồn và ràng buộc đã đầy đủ chưa?
Câu trả lời có hợp lý không? Tôi có hiểu logic và có thể giải thích lại bằng lời của mình không?
AI có thể sai ở đâu? Tôi đã xem xét giả định, thiên lệch, trường hợp ngoại lệ và phương án đối lập chưa?
Quyết định cuối cùng là của ai? Tôi có sẵn sàng chịu trách nhiệm cho việc sử dụng kết quả này không?
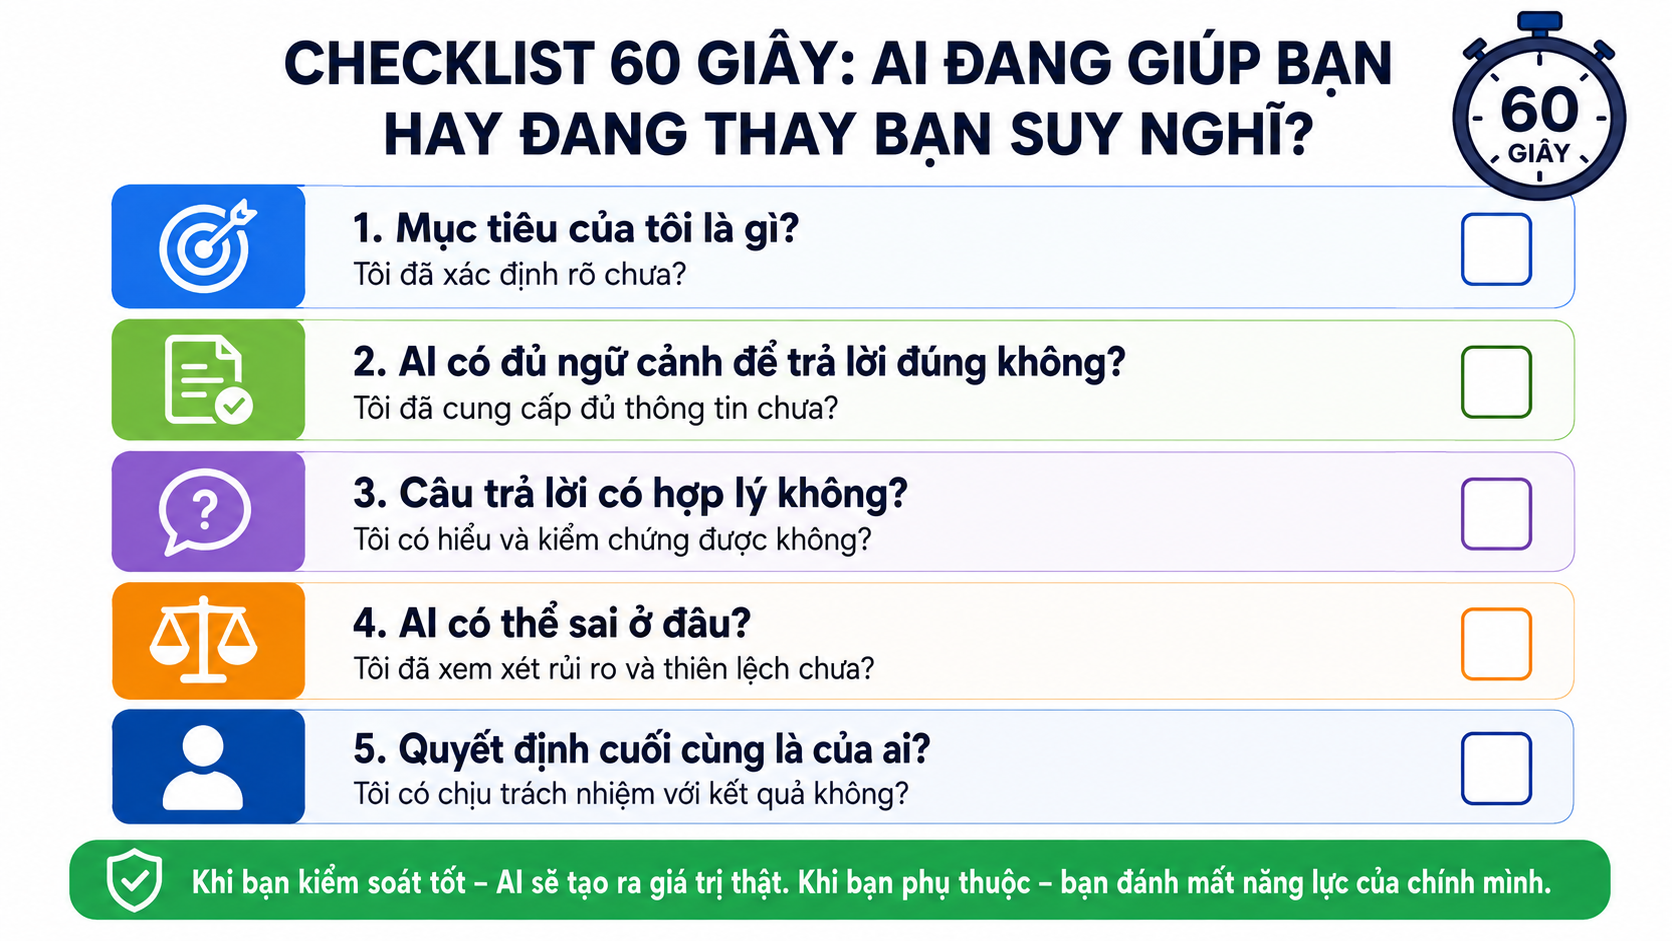
Checklist 60 giây gồm năm câu hỏi giúp người dùng kiểm tra mức độ chủ động và tư duy phản biện khi dùng AI
Checklist này không làm biến mất sai sót, nhưng nó tạo ra một cognitive forcing moment: buộc người dùng chuyển từ trạng thái tiêu thụ thụ động sang trạng thái giám sát chủ động. Điều này phù hợp với bằng chứng rằng một số can thiệp tạo “ma sát” có thể giảm overreliance [8].
10. Ba cấp độ sử dụng 5C
Cấp 1 — Tác vụ tạo nội dung
Ví dụ: viết email, tạo ý tưởng, tóm tắt, soạn outline.
Clarify: mục đích và đối tượng.
Context: tone, dữ kiện, tài liệu nguồn.
Command: cấu trúc, độ dài, format.
Challenge: tạo 2–3 phiên bản, chỉ ra trade-off.
Check: rà facts, tone, tính phù hợp.
Ở cấp này, AI có thể đảm nhận tỷ lệ lớn công việc sản xuất nội dung, nhưng người dùng vẫn cần sở hữu tiêu chí chất lượng.
Cấp 2 — Tác vụ phân tích và học tập
Ví dụ: phân tích nghiên cứu, xây lesson plan, giải thích khái niệm, phân tích dữ liệu.
Ở đây Challenge và Check trở nên quan trọng hơn. Người dùng nên yêu cầu:
Nếu người học chỉ yêu cầu “cho đáp án”, AI có thể làm giảm cơ hội thực hành các thao tác nhận thức. Nghiên cứu về GenAI và critical thinking cho thấy sự chuyển dịch của tư duy từ production sang verification/integration/stewardship; điều này hàm ý thiết kế hoạt động học nên đánh giá cả cách người học kiểm chứng và biện minh, không chỉ sản phẩm cuối [7].
Cấp 3 — Tác vụ quyết định có rủi ro
Ví dụ: chính sách, tuyển dụng, tài chính, sức khỏe, pháp lý.
Ở cấp này, 5C chỉ là minimum interaction discipline, không phải cơ chế đảm bảo an toàn. Cần bổ sung:
quy trình human review;
nguồn dữ liệu chính thức;
audit trail;
phân quyền quyết định;
kiểm soát privacy/security;
tiêu chí escalation khi AI không chắc chắn.
11. Ứng dụng 5C trong giáo dục: từ “dùng AI” sang “học cách làm chủ AI”
AI literacy ở K–12 đang được mô tả như một năng lực đa chiều, không chỉ bao gồm kiến thức kỹ thuật mà còn khả năng hiểu, đánh giá và tương tác với AI [1,2]. UNESCO cũng nhấn mạnh human-centred mindset, ethics, application skills và AI system design trong framework dành cho học sinh; framework dành cho giáo viên bổ sung AI pedagogy và professional learning [16,17].
Từ góc độ đó, 5C có thể trở thành routine lớp học hơn là một bài “prompt engineering” đơn lẻ.
11.1. Ví dụ: học sinh dùng AI để tìm hiểu một hiện tượng khoa học
Clarify: “Em đang cần giải thích hiện tượng gì? Cần sản phẩm nào: poster, báo cáo hay thí nghiệm?”
Context: học sinh đưa dữ kiện thí nghiệm, cấp lớp, thuật ngữ đã học.
Command: yêu cầu AI giải thích theo cấu trúc “quan sát – nguyên nhân – bằng chứng – ví dụ”.
Challenge: yêu cầu AI đưa một giải thích thay thế và nêu dữ liệu nào có thể phân biệt hai giả thuyết.
Check: học sinh đối chiếu sách giáo khoa, nguồn khoa học hoặc dữ liệu thực nghiệm.
Ở đây AI không thay khoa học inquiry; nó trở thành đối tượng để học sinh thực hành inquiry.
11.2. Thiết kế đánh giá phù hợp
Nếu giáo viên muốn tránh sự phụ thuộc, rubric không nên chỉ chấm sản phẩm cuối. Có thể thêm tiêu chí:
Mức độ rõ ràng của mục tiêu.
Chất lượng context và nguồn.
Khả năng đặt yêu cầu có ràng buộc.
Chất lượng phản biện/chất vấn AI.
Chất lượng kiểm chứng và giải thích quyết định cuối.
Cách đánh giá này đưa “quá trình kiểm soát AI” trở thành bằng chứng học tập, thay vì cố gắng phát hiện đơn giản học sinh có dùng AI hay không.
12. Điều 5C không giải quyết được
Một framework thực hành chỉ có giá trị khi ranh giới của nó được nói rõ.
12.1. 5C không bảo đảm AI đúng
Prompt tốt có thể cải thiện relevance và cấu trúc, nhưng không loại bỏ hallucination [10].
12.2. 5C không thay domain expertise
Người không có kiến thức chuyên môn có thể khó nhận ra một câu trả lời sai nhưng thuyết phục. Nghiên cứu về automation bias cho thấy mức độ chuyên môn và AI literacy có thể ảnh hưởng cách người dùng dựa vào hệ thống [9].
12.3. 5C không thay governance
Privacy, security, copyright, fairness, dữ liệu cá nhân, trách nhiệm pháp lý và quyền truy cập cần chính sách và quy trình riêng. UNESCO Guidance nhấn mạnh các lớp quản trị này trong triển khai GenAI cho giáo dục và nghiên cứu [15].
12.4. Challenge có thể tạo “ảo giác kiểm chứng”
Việc yêu cầu AI tự phản biện có thể cải thiện output trong một số setting [12,13], nhưng cùng một mô hình vẫn có thể chia sẻ cùng knowledge gap hoặc sai lệch. External verification vẫn cần thiết với claim quan trọng.
12.5. “Tư duy nhiều hơn” cũng có chi phí
Cognitive forcing làm người dùng tốn công hơn và đôi khi giảm trải nghiệm chủ quan [8]. Vì vậy, không phải mọi tác vụ đều cần quy trình kiểm chứng nặng như nhau. Cần risk-based verification.
13. Mô hình trưởng thành 5C: từ người hỏi đến người điều phối AI
Có thể xem năng lực giao tiếp AI phát triển qua bốn mức:
Mức 1 — Ask: đặt câu hỏi và nhận câu trả lời.
Mức 2 — Specify: biết Clarify, Context, Command để mô tả nhiệm vụ tốt hơn.
Mức 3 — Critique: biết Challenge và Check; phân biệt câu trả lời “hay” với câu trả lời có bằng chứng.
Mức 4 — Orchestrate: biết chia nhiệm vụ, dùng nhiều nguồn/công cụ, thiết kế điểm kiểm soát, theo dõi provenance và chịu trách nhiệm cuối.
Mức trưởng thành cao không phải là “prompt dài hơn”, mà là quản trị vòng đời nhiệm vụ với AI tốt hơn.
14. Hướng nghiên cứu để biến 5C từ framework thực hành thành mô hình được kiểm định
Nếu muốn phát triển 5C thành một framework khoa học có thể sử dụng trong giáo dục hoặc tổ chức, cần vượt qua giai đoạn conceptual synthesis. Một chương trình nghiên cứu hợp lý có thể gồm:
14.1. Operationalize từng C
Xây chỉ báo quan sát được, ví dụ:
Clarify: có mục tiêu, tiêu chí thành công, risk level.
Context: tỷ lệ context liên quan, provenance nguồn.
Command: task specificity, output constraints.
Challenge: số lượng/độ sâu phản giả thuyết, counterexample.
Check: số claim được xác minh, chất lượng nguồn, correction rate.
14.2. Xây rubric và kiểm định độ tin cậy
Cần inter-rater reliability, construct validity và phân tích xem 5 thành phần có thực sự tách biệt hay không.
14.3. Thử nghiệm có đối chứng
So sánh nhóm sử dụng 5C với nhóm prompt thông thường trên các biến:
14.4. Kiểm tra theo độ tuổi và chuyên môn
Một framework dùng cho học sinh 9 tuổi không thể giữ nguyên cách triển khai cho bác sĩ hoặc kỹ sư. Cần điều chỉnh wording, độ sâu Challenge và mức Check theo domain expertise và stakes.
14.5. Đánh giá hiệu ứng dài hạn
Câu hỏi quan trọng nhất không chỉ là “5C có làm câu trả lời tốt hơn không?” mà là:
Sau nhiều tháng dùng 5C, người học/người làm việc có tăng khả năng tự xác định vấn đề, phản biện và kiểm chứng khi không có AI hay không?
Đây mới là tiêu chí trực tiếp liên quan tới mục tiêu “dùng AI mà không phụ thuộc vào AI”.
15. Kết luận: mục tiêu không phải prompt hoàn hảo, mà là quyền chủ động nhận thức
Khung 5C có giá trị nhất khi được hiểu như một vòng kiểm soát human-in-the-loop:
Clarify giữ quyền xác định mục tiêu.
Context giữ quyền xác định thông tin nào được đưa vào.
Command giữ quyền xác định tiêu chuẩn đầu ra.
Challenge giữ quyền phản biện và mở rộng phương án.
Check giữ quyền đánh giá bằng chứng và ra quyết định.
Research về human–AI interaction, AI literacy, critical thinking và automation bias cùng hội tụ ở một thông điệp: hiệu quả của AI không chỉ phụ thuộc vào model capability; nó phụ thuộc vào cách con người phân bổ quyền kiểm soát và nỗ lực nhận thức trong quá trình tương tác [1–3,7–9].
Vì vậy, câu hỏi tốt nhất để kết thúc một phiên làm việc với AI không phải là “AI đã trả lời hay chưa?”, mà là:
Tôi có hiểu, kiểm chứng và sẵn sàng chịu trách nhiệm cho kết quả này không?
Key takeaways
5C trong bài này là framework tổng hợp dựa trên bằng chứng, chưa phải mô hình đã được peer-review và kiểm định đúng với năm thành phần Clarify–Context–Command–Challenge–Check.
Clarify–Context–Command cải thiện việc đặc tả nhiệm vụ; Challenge–Check bảo vệ năng lực phản biện và giảm nguy cơ overreliance.
Prompt engineering giúp tăng chất lượng tương tác nhưng không loại bỏ hallucination.
Cognitive forcing và yêu cầu phản biện có thể giảm phụ thuộc mù quáng, nhưng đi kèm chi phí nhận thức.
Trong giáo dục, nên đánh giá quy trình sử dụng AI — mục tiêu, nguồn, chất vấn, kiểm chứng — chứ không chỉ sản phẩm cuối.
Với nhiệm vụ rủi ro cao, 5C là lớp kỷ luật tối thiểu; vẫn cần chuyên gia, nguồn sơ cấp và governance.
FAQ
Khung 5C có phải framework prompt engineering đã được khoa học chứng minh không?
Chưa. Trong phạm vi tìm kiếm của bài viết, chưa có công trình peer-reviewed kiểm định đúng chuỗi Clarify–Context–Command–Challenge–Check như một mô hình chuẩn hóa. 5C ở đây là framework tổng hợp ánh xạ nhiều nguyên tắc đã có bằng chứng từ prompt engineering, AI literacy, HCI, metacognition và overreliance research.
5C khác gì một template prompt?
Template prompt chủ yếu giúp mô tả đầu vào. 5C bổ sung hai bước sau generation — Challenge và Check — nhằm duy trì tư duy phản biện và quyền quyết định của người dùng.
Có thể bỏ Check nếu AI đã trích nguồn không?
Không nên. LLM có thể tạo citation sai, trích nguồn không hỗ trợ claim hoặc diễn giải sai tài liệu. Nguồn quan trọng cần được mở và kiểm tra trực tiếp.
Challenge có giúp loại bỏ hallucination không?
Không hoàn toàn. Các kỹ thuật refinement/verification có thể giảm lỗi trong một số benchmark, nhưng không bảo đảm phát hiện mọi sai sót. External verification vẫn cần cho claim quan trọng.
5C có phù hợp cho học sinh không?
Có thể, nếu đơn giản hóa ngôn ngữ và thiết kế theo lứa tuổi. Với học sinh nhỏ, mỗi C có thể trở thành một câu hỏi ngắn: “Em muốn gì?”, “AI cần biết gì?”, “Em yêu cầu thế nào?”, “Có cách khác không?”, “Em kiểm tra bằng đâu?”.
Tài liệu tham khảo
Long, D., & Magerko, B. (2020). What is AI Literacy? Competencies and Design Considerations. CHI 2020. https://doi.org/10.1145/3313831.3376727
Casal-Otero, L., Catala, A., Fernández-Morante, C., et al. (2023). AI literacy in K-12: a systematic literature review. International Journal of STEM Education, 10, 29. https://doi.org/10.1186/s40594-023-00418-7
Amershi, S., Weld, D., Vorvoreanu, M., et al. (2019). Guidelines for Human-AI Interaction. CHI 2019. https://doi.org/10.1145/3290605.3300233
Schulhoff, S., Ilie, M., Balepur, N., et al. (2024). The Prompt Report: A Systematic Survey of Prompting Techniques. arXiv:2406.06608. https://arxiv.org/abs/2406.06608
Liu, Y.-Y., Zheng, Z., Zhang, F., et al. (2026). A comprehensive taxonomy of prompt engineering techniques for large language models. Frontiers of Computer Science. https://doi.org/10.1007/s11704-025-50058-z
White, J., Fu, Q., Hays, S., et al. (2023). A Prompt Pattern Catalog to Enhance Prompt Engineering with ChatGPT. PLoP 2023. https://doi.org/10.64346/PLoP2023p05
Lee, H.-P., Sarkar, A., Tankelevitch, L., et al. (2025). The Impact of Generative AI on Critical Thinking: Self-Reported Reductions in Cognitive Effort and Confidence Effects From a Survey of Knowledge Workers. CHI 2025. https://doi.org/10.1145/3706598.3713778
Buçinca, Z., Malaya, M. B., & Gajos, K. Z. (2021). To Trust or to Think: Cognitive Forcing Functions Can Reduce Overreliance on AI in AI-Assisted Decision-Making. Proceedings of the ACM on Human-Computer Interaction, 5(CSCW1). https://doi.org/10.1145/3449287
Romeo, G., & Conti, D. (2026). Exploring automation bias in human–AI collaboration: a review and implications for explainable AI. AI & Society. https://doi.org/10.1007/s00146-025-02422-7
Huang, L., Yu, W., Ma, W., et al. (2025). A Survey on Hallucination in Large Language Models: Principles, Taxonomy, Challenges, and Open Questions. ACM Transactions on Information Systems, 43(2). https://doi.org/10.1145/3703155
Dhuliawala, S., Komeili, M., Xu, J., et al. (2023). Chain-of-Verification Reduces Hallucination in Large Language Models. arXiv:2309.11495. https://arxiv.org/abs/2309.11495
Madaan, A., Tandon, N., Gupta, P., et al. (2023). Self-Refine: Iterative Refinement with Self-Feedback. NeurIPS 2023. https://doi.org/10.52202/075280-2019
Yao, S., Yu, D., Zhao, J., et al. (2023). Tree of Thoughts: Deliberate Problem Solving with Large Language Models. NeurIPS 2023. https://doi.org/10.52202/075280-0517
Xu, X., Qiao, L., Cheng, N., & Liu, H. (2025). Enhancing self-regulated learning and learning experience in generative AI environments: The critical role of metacognitive support. British Journal of Educational Technology. https://doi.org/10.1111/bjet.13599
Miao, F., & Holmes, W. (2023). Guidance for generative AI in education and research. UNESCO. https://www.unesco.org/en/articles/guidance-generative-ai-education-and-research
Miao, F., Shiohira, K., & Lao, N. (2024). AI competency framework for students. UNESCO. https://www.unesco.org/en/articles/ai-competency-framework-students
Miao, F., & Cukurova, M. (2024). AI competency framework for teachers. UNESCO. https://www.unesco.org/en/articles/ai-competency-framework-teachers
Iqbal, J., Hashmi, Z. F., Asghar, M. Z., et al. (2025). Generative AI tool use enhances academic achievement in sustainable education through shared metacognition and cognitive offloading among preservice teachers. Scientific Reports, 15, 16610. https://doi.org/10.1038/s41598-025-01676-X
Khung 5C có phải mô hình khoa học đã được kiểm định không?
Chưa có bằng chứng peer-reviewed kiểm định đúng chuỗi Clarify–Context–Command–Challenge–Check như một mô hình chuẩn hóa. Bài viết định vị 5C là framework tổng hợp thực hành dựa trên nhiều nhánh nghiên cứu liên quan.
5C khác gì template prompt?
Template prompt chủ yếu cấu trúc đầu vào. 5C bổ sung Challenge và Check để buộc người dùng phản biện, kiểm chứng và giữ quyền quyết định sau khi AI đã tạo câu trả lời.
Có cần Check nếu AI đã dẫn nguồn?
Có. Nguồn do AI đưa ra có thể sai, không tồn tại hoặc không hỗ trợ claim. Với thông tin quan trọng, cần mở nguồn gốc và kiểm tra trực tiếp.
Challenge có loại bỏ hallucination không?
Không. Phản biện và refinement có thể giảm lỗi trong một số tình huống, nhưng không bảo đảm mô hình nhận ra mọi sai sót của chính nó.
Có thể dùng 5C cho học sinh không?
Có, nếu đơn giản hóa theo lứa tuổi và biến mỗi C thành một câu hỏi ngắn về mục tiêu, ngữ cảnh, yêu cầu, phương án khác và nguồn kiểm chứng.
Nguồn tham chiếu nghiên cứu (Citations):
What is AI Literacy? Competencies and Design Considerations
AI literacy in K-12: a systematic literature review
Guidelines for Human-AI Interaction
The Prompt Report: A Systematic Survey of Prompting Techniques
A comprehensive taxonomy of prompt engineering techniques for large language models
A Prompt Pattern Catalog to Enhance Prompt Engineering with ChatGPT
The Impact of Generative AI on Critical Thinking
To Trust or to Think: Cognitive Forcing Functions Can Reduce Overreliance on AI
Exploring automation bias in human–AI collaboration
A Survey on Hallucination in Large Language Models
Chain-of-Verification Reduces Hallucination in Large Language Models
Self-Refine: Iterative Refinement with Self-Feedback
Tree of Thoughts: Deliberate Problem Solving with Large Language Models
Enhancing self-regulated learning and learning experience in generative AI environments
Guidance for generative AI in education and research
AI competency framework for students
AI competency framework for teachers
Generative AI tool use enhances academic achievement through shared metacognition and cognitive offloading